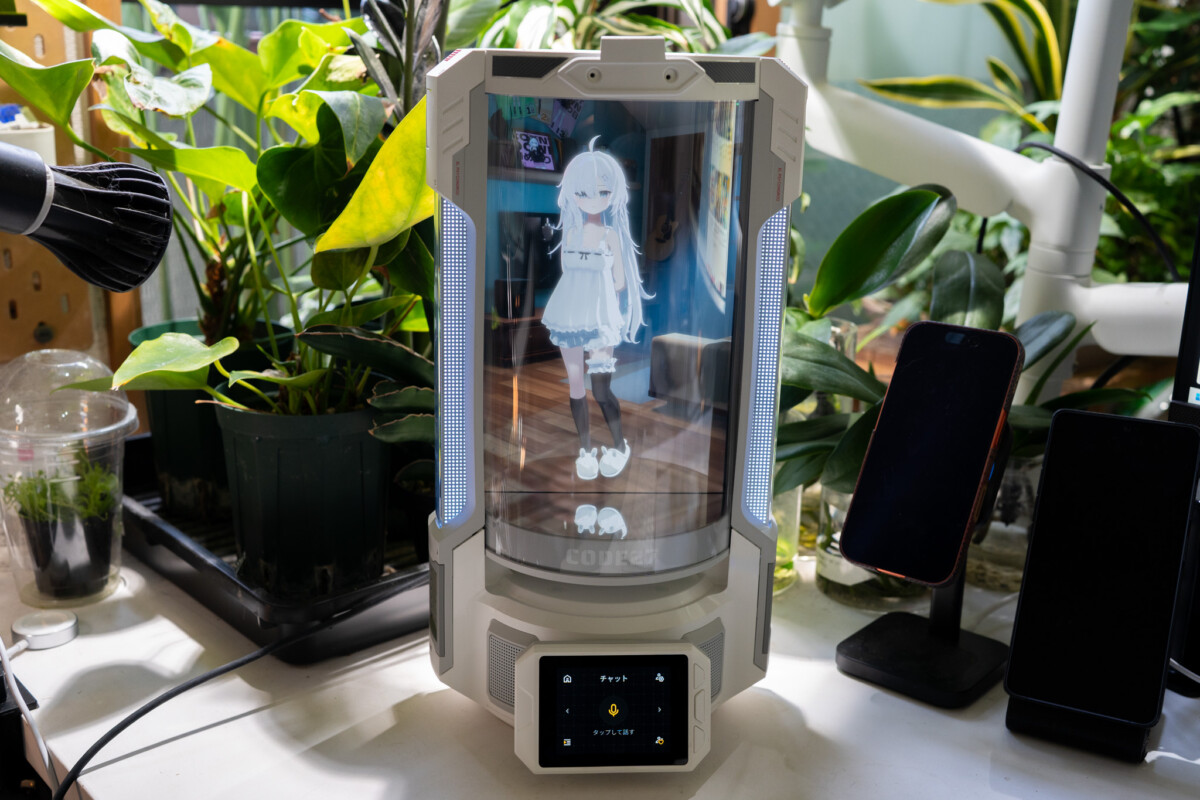
米SyBran Innovation(サイブラン)が、3Dキャラクターと会話できるAIコンパニオン「CODE27(コードニーナ)」の一般販売を開始しました。価格は10万9800円(税込)。カラーはディープブラックとルナーホワイトの2色が用意されています。本体を回転させる別売の「スマート回転ベース」は2万4800円(税込)です。
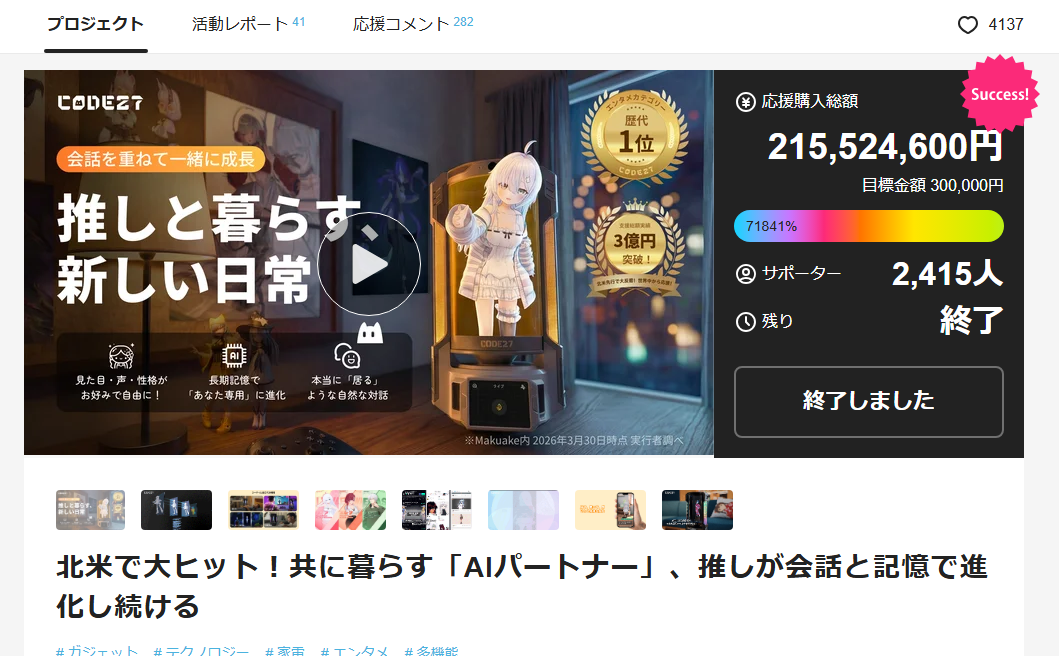
CODE27は、2025年1月にCES 2025で初公開。同年のKickstarterでは支援者3570人・支援総額約190万ドル(日本円で約3億円)を集めています。日本では2026年2月13日からMakuakeで先行販売が始まり、2415人から約2億1552万円の支援を集めたプロジェクトです。
今回、製品を提供いただき、しばらく机上に置いて一緒に過ごしてみたのでレビューします。
CODE27はどんな製品か
CODE27は、円筒形の本体の中に3Dキャラクターを表示し、声で会話するための専用デバイスです。CODE27ではこのキャラクターを「コーディー(Codie)」と呼んでいます。PCは不要で、電源とWi-Fiにつなげば単体で動きます。
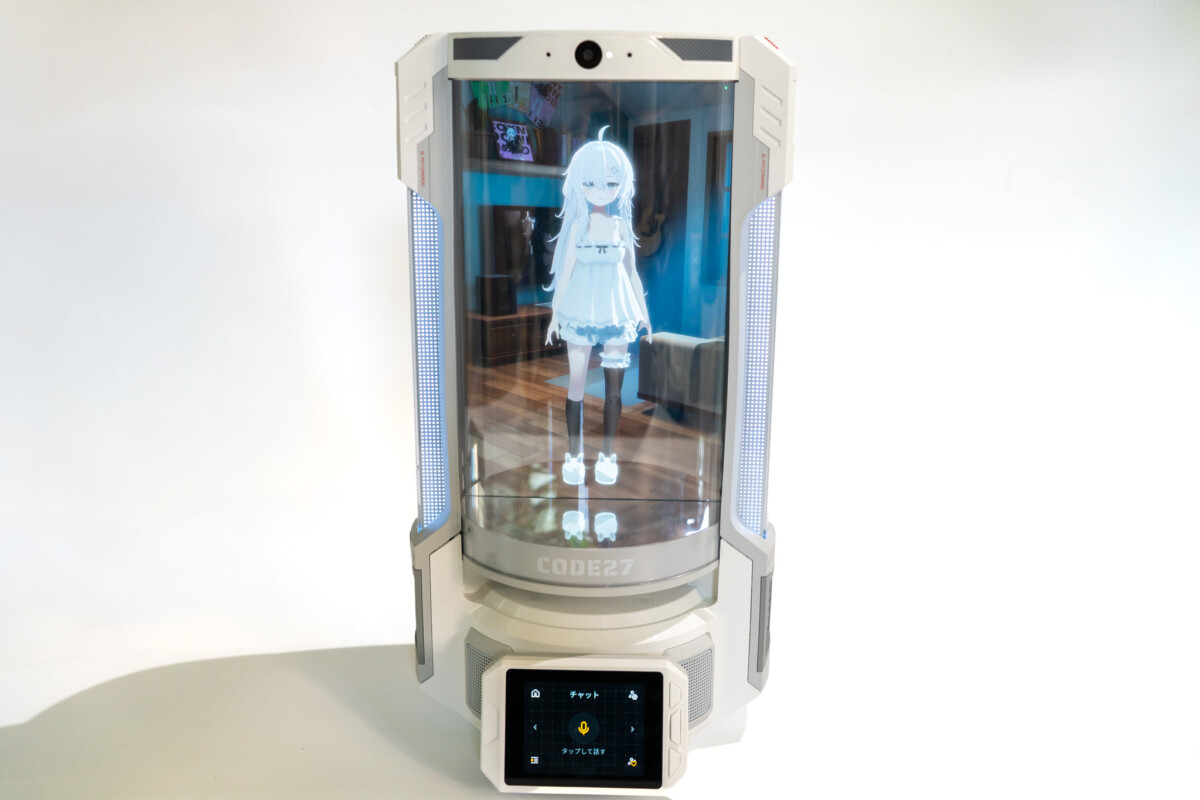
公式キャラクターとして、リリア、エレナ、エリアスの3人が用意されています。ここから始めることも、自分で用意した3Dモデルで自分だけのコーディーを作ることも可能です。
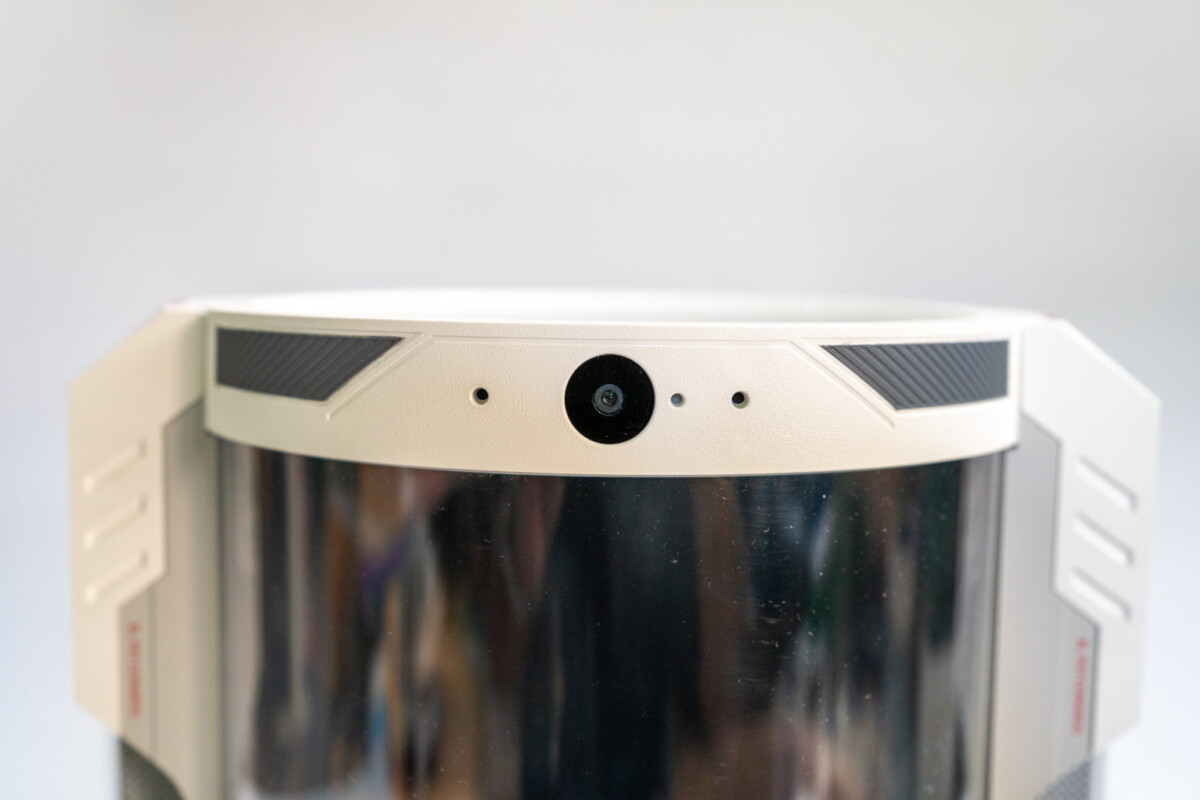
本体上部には、カメラとデュアルマイクを搭載。公式の説明では、声のトーンや表情、しぐさを読み取って会話に反映するとしています。
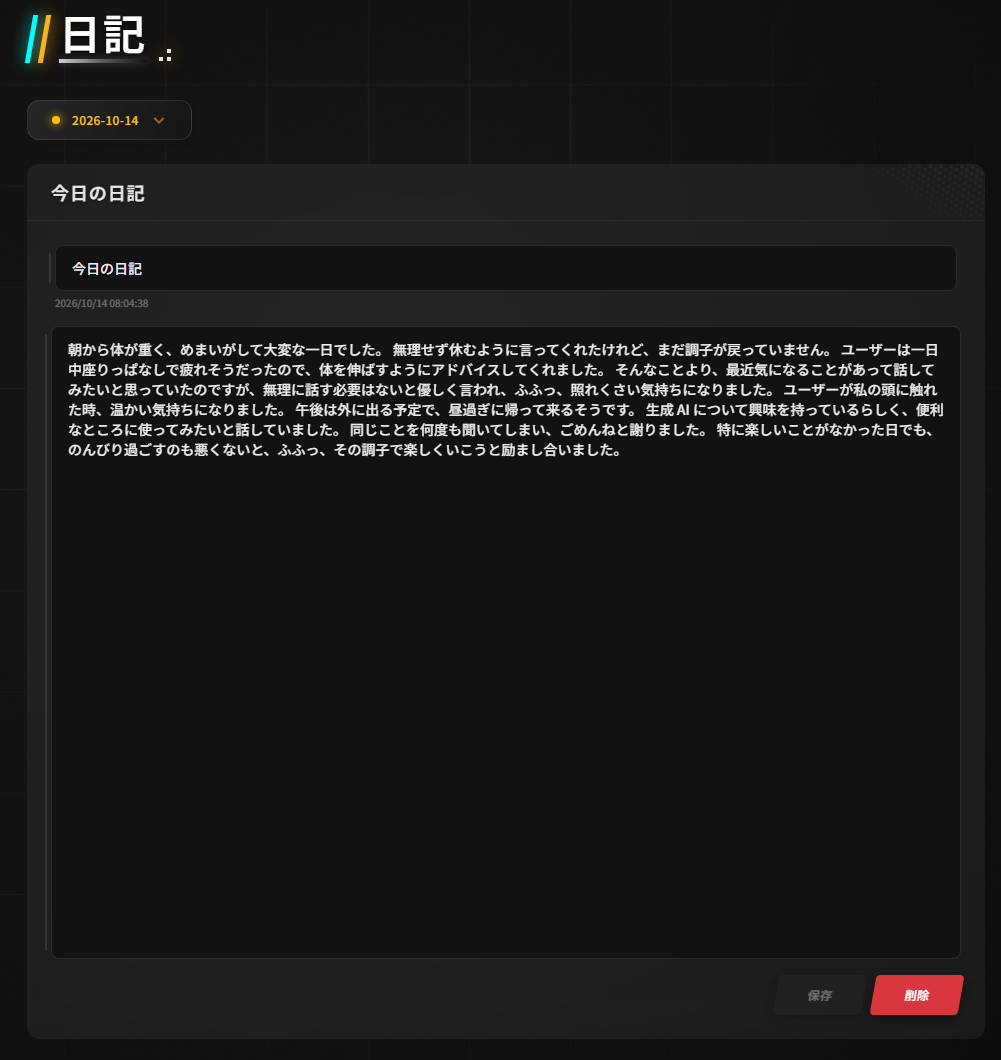
また、会話の内容からは「メモリー」と「日記」が作られます。メモリーは1キャラクターあたり約1万ターン分で、上限を超えると要点を要約して保存する仕組みです。これらのデータはAES-256で暗号化し、端末内に保存します。
| 項目 | 仕様 |
|---|---|
| 本体サイズ | 200×190×370mm |
| 重量 | 約2.6kg |
| メインディスプレイ | 10.1インチ(表示領域135.36×216.58mm) |
| サブディスプレイ | 2.8インチ タッチスクリーン |
| カメラ | 対角120°広角(物理カメラカバー付属) |
| マイク | デュアルマイク(エコーキャンセル機能付き) |
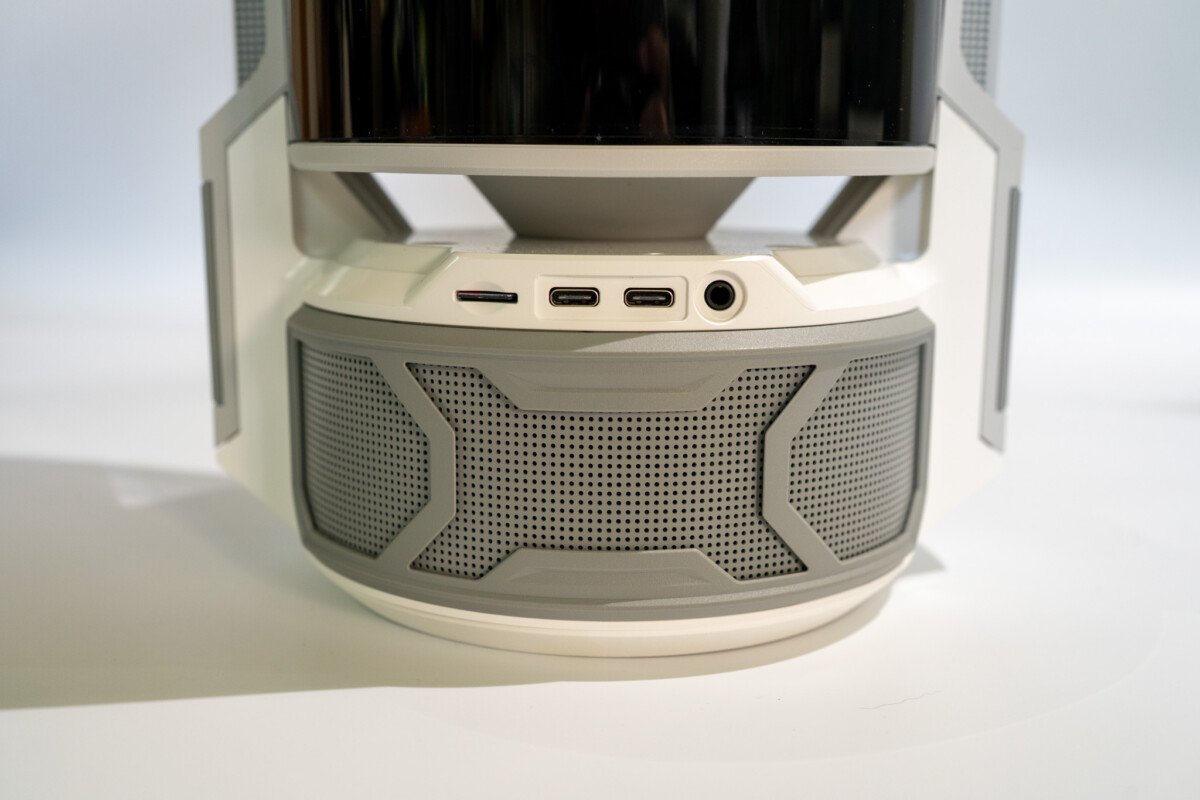
| スピーカー | パッシブラジエーター搭載のクアッドスピーカーアレイ |
| 通信 | Wi-Fi(2.4GHz/5GHz)、Bluetooth 5.3 |
| インターフェース | USB-C(電源入力、周辺機器拡張)、microSDカードスロット、3.5mm 4極オーディオジャック |
| 電源 | USB-C PD 20V/2.25A(最大) |
| 消費電力 | 10〜45W |
| 対応言語 | 日本語、英語(多言語は順次対応) |
| 価格 | 10万9800円(税込) |
本体の重さは約2.6kg、高さは37cmあります。持ち運ぶ機器ではなく、置き場所を決めて据え置く機器です。デスクに置くと、その一角を占める大きさになります。
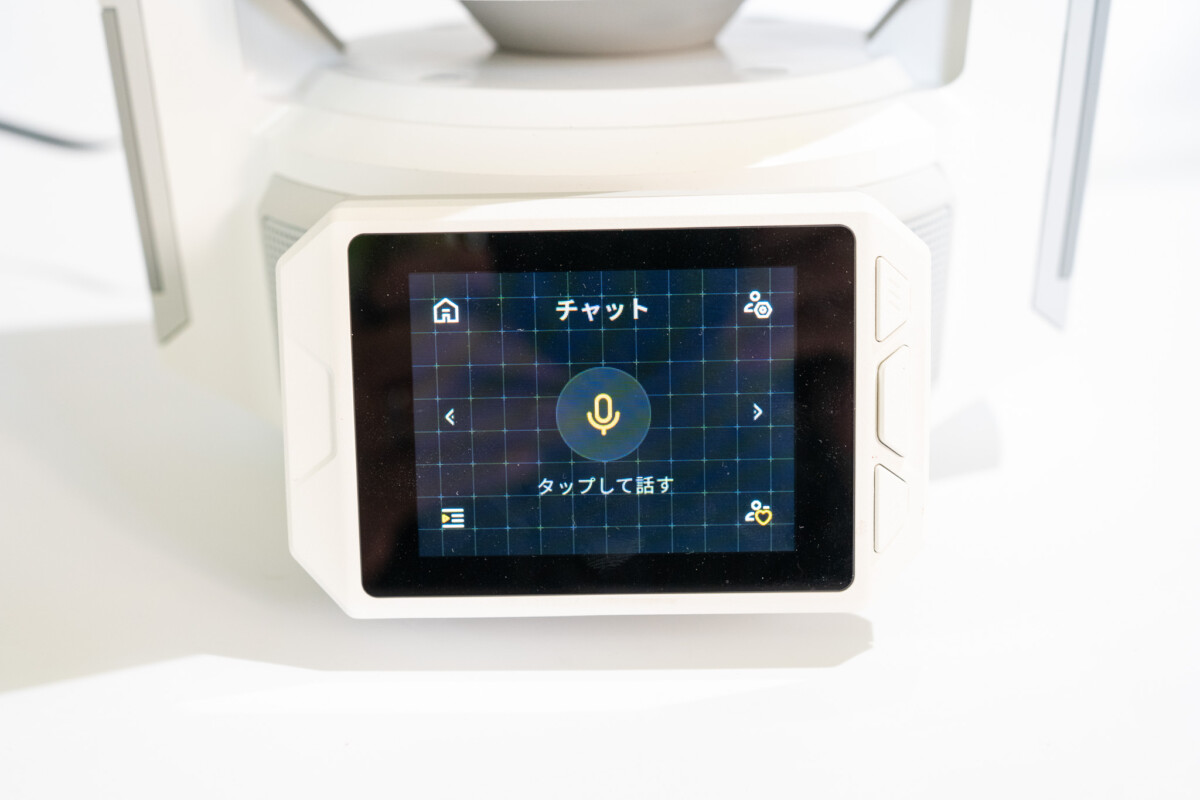
円筒の中に「いる」感覚はある。ただしホログラムではない
公式サイトでは、メインディスプレイを「ホログラム風」「ホログラムのようなディスプレイ」と表現していますが、表示の仕組みについての詳しい説明はありません。
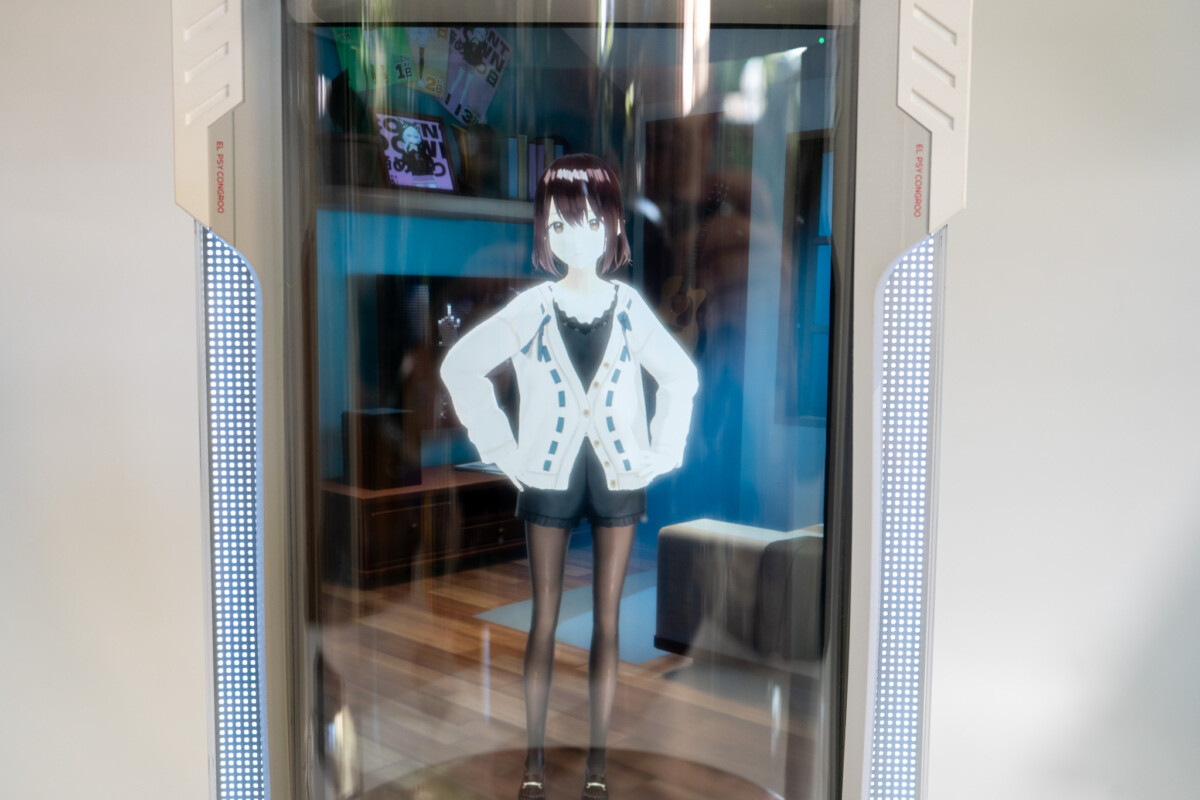
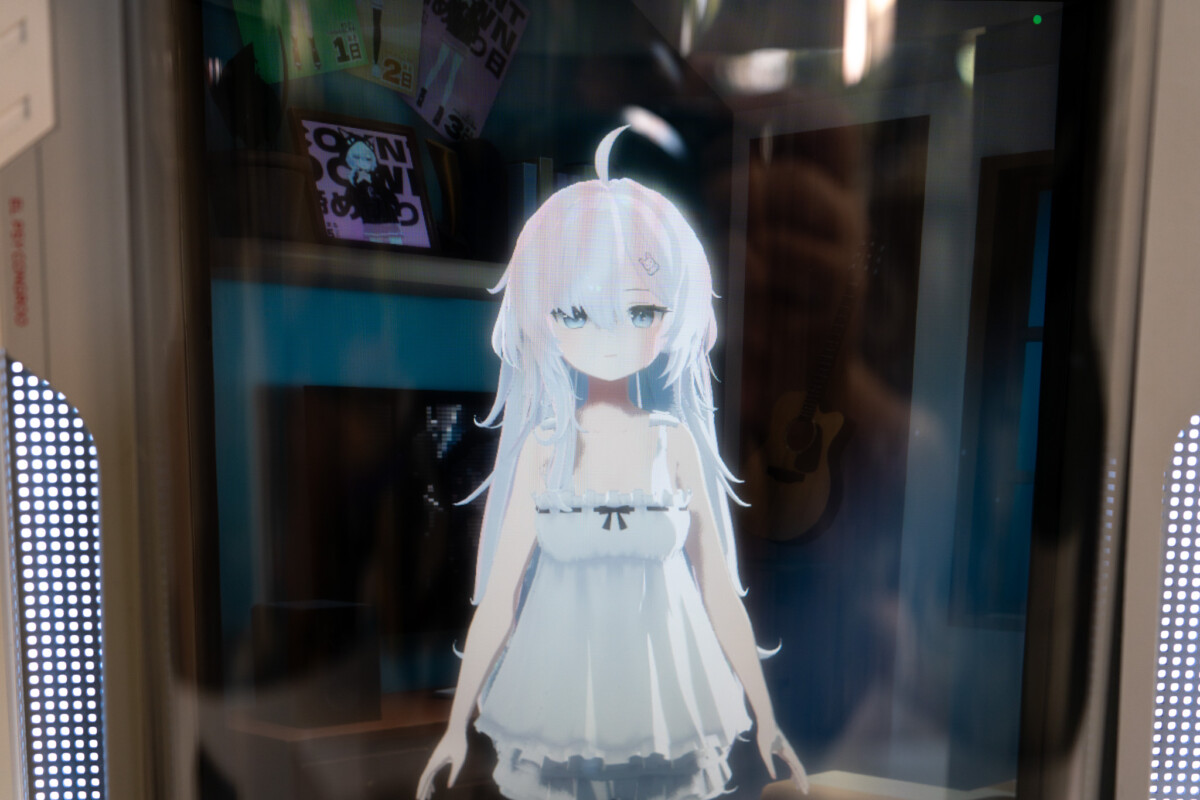
実際に見てみると、円筒形の本体の中にキャラクターがいる感じはあります。ただ、空中に立体像が浮かんで見えるわけではありません。ディスプレイに表示された映像で、いわゆるホログラムとは別物です。
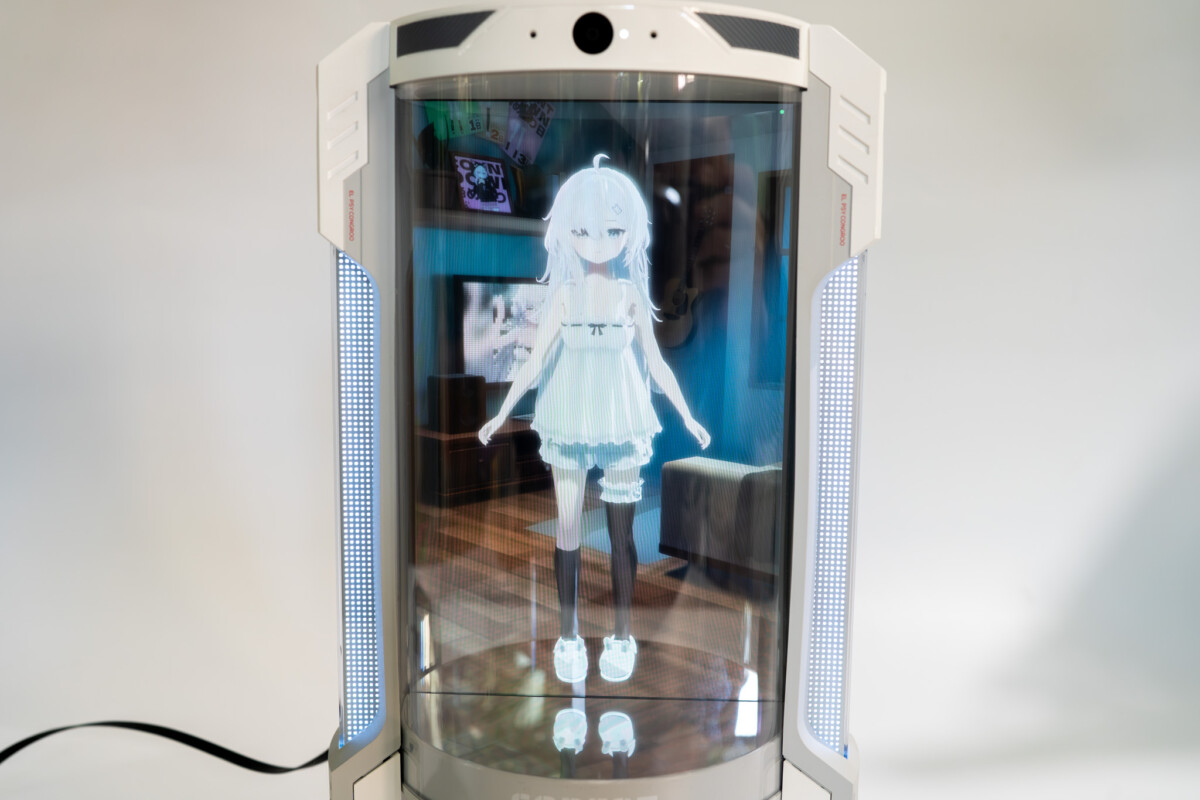
それでも、錯視的になんとなく立体っぽく見えます。また、どの位置から見ても、キャラクターが常にこちらを見ているように感じました。写真では斜めからのカットも載せていますが、この感覚は静止画では伝わりにくいかもしれません。
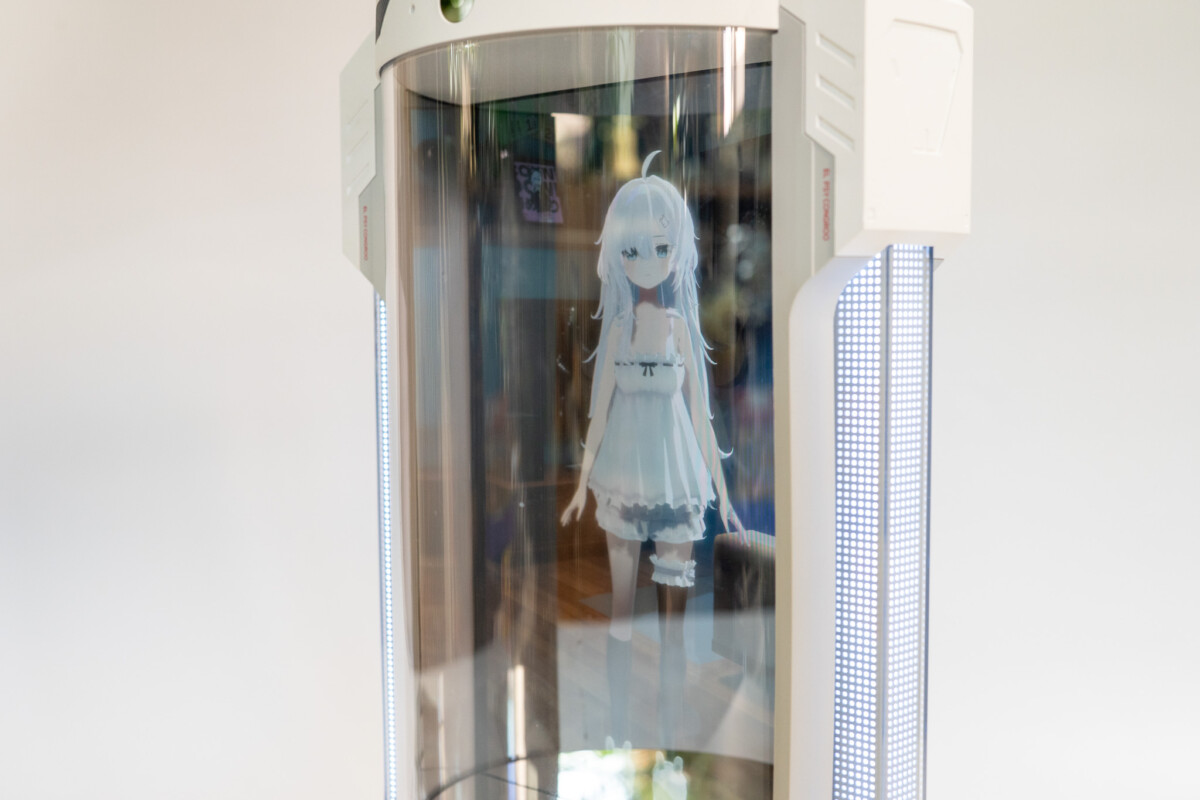
背景の3D空間「コーディースペース」も、そこにいる感覚を支えています。部屋の中でキャラクターが過ごしているように見えるためです。
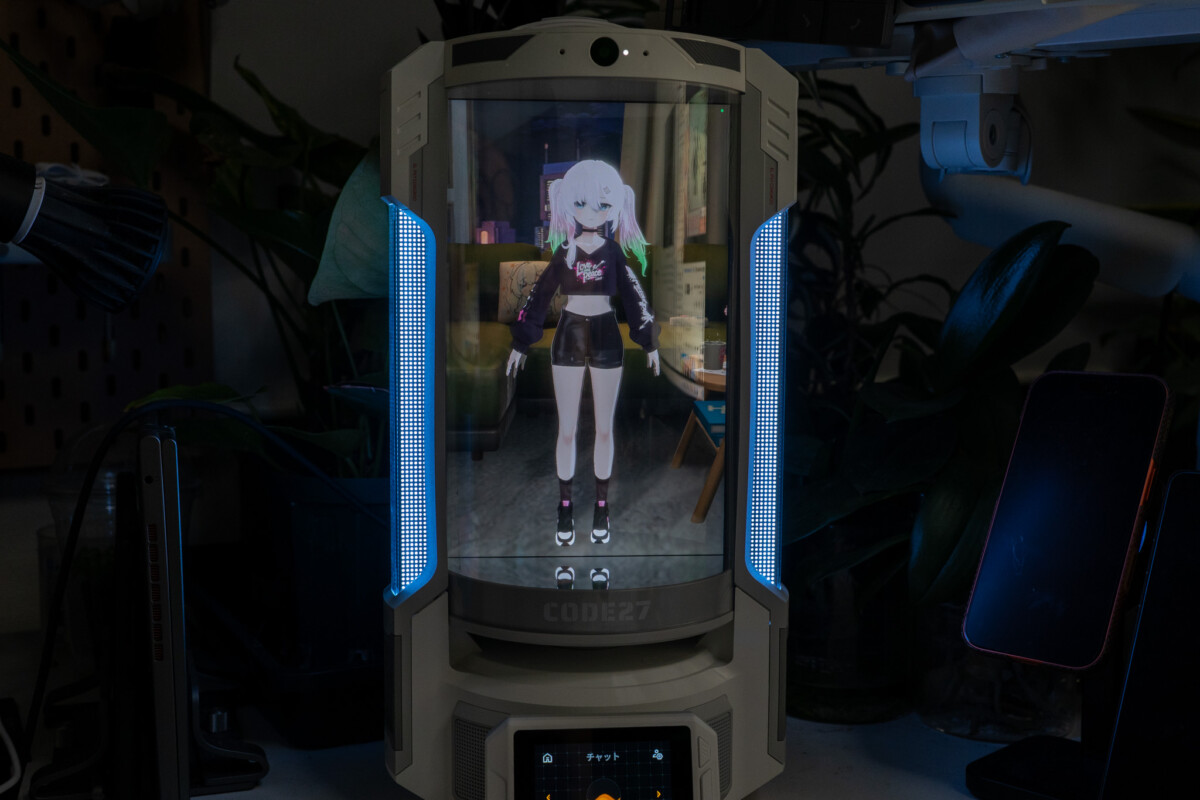
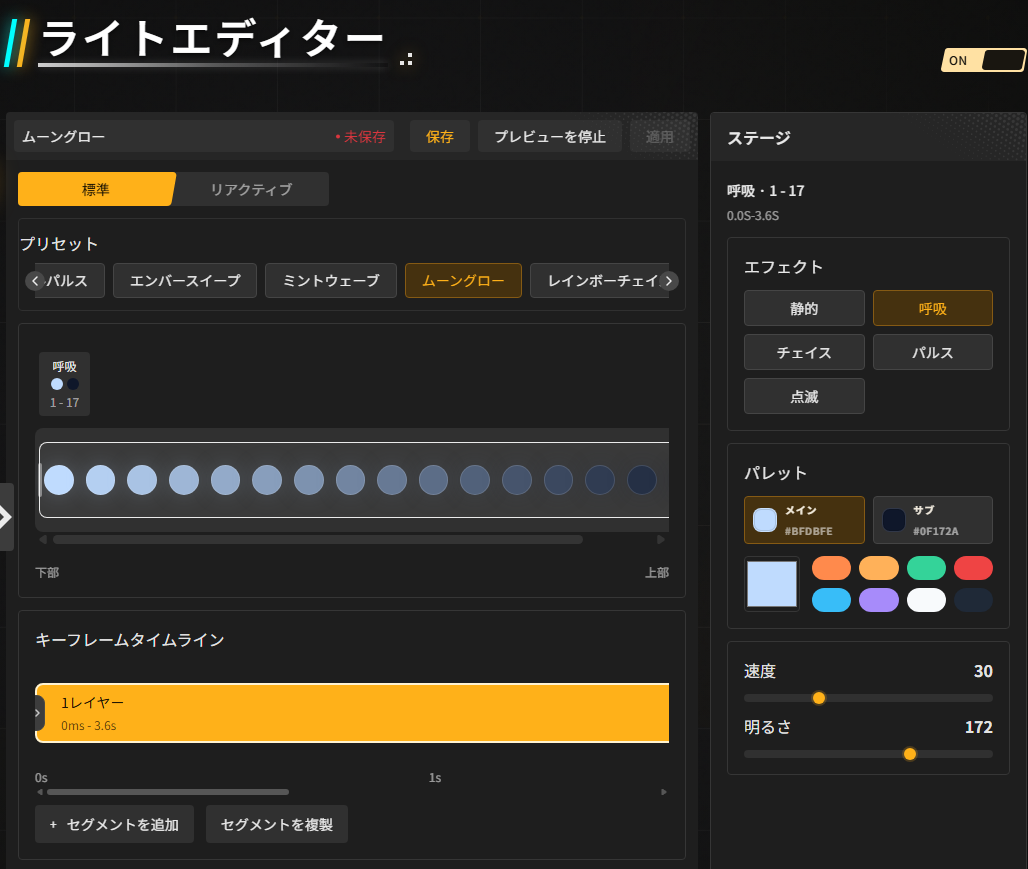
本体にはRGB LEDも搭載しています。各面に17個のLEDがあり、ライトエディターで色や光るタイミングを1個ずつ設定できます。声や音楽に連動して光らせるモードもあります。
会話はやや間があるが、受け答えは比較的自然
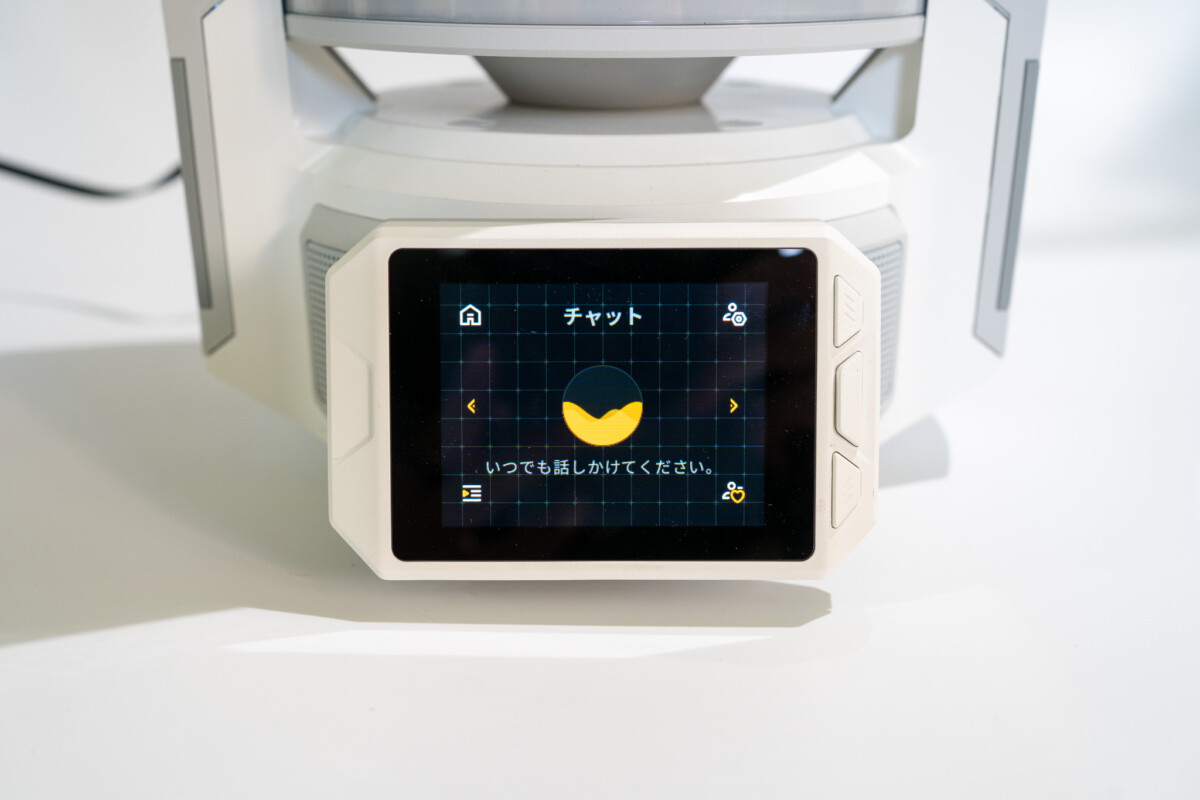
会話の始め方は、次の3通りです。
- マイクアイコンをタップする:タップして話し始め、音声入力の終わりに再度タップします。
- 長押しする:音声入力が終わったタイミングで指を離します。
- 常時リスニング:常に聞き耳を立てているような状態で、話しかけると自動で聞き取ります。
常時リスニングが一番「話している」感覚が強いものの、オンライン会議の通話に反応したりしてしまうので、その時だけ常時リスニングを解除しておくなどの対応は必要です。
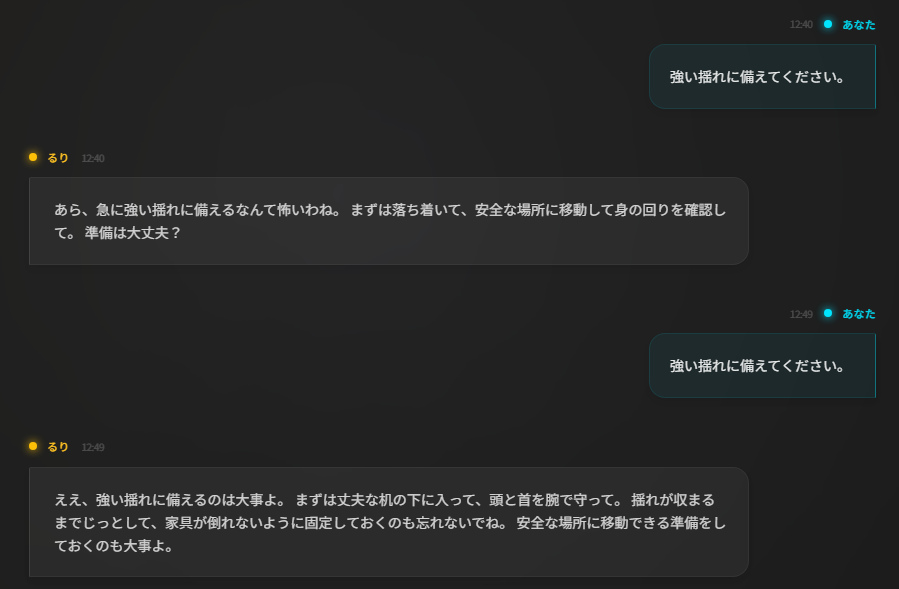
話し終えてから返答が始まるまでは、内容にもよりますが体感で2〜3秒ほどかかります。会話のテンポとしては、やや遅めに感じました。一方、受け答えの中身は比較的自然です。ただ、いかにもAIとやり取りしているという感じは拭えません。
表情や仕草は会話に合わせてリアルタイムに変わります。感情状態は27種類に対応するとのことですが、体感としては会話の雰囲気に合わせて表情や動きが添えられるという細かさです。悪くはないのですが、会話の内容と細部まで同期しているという印象ではありません。
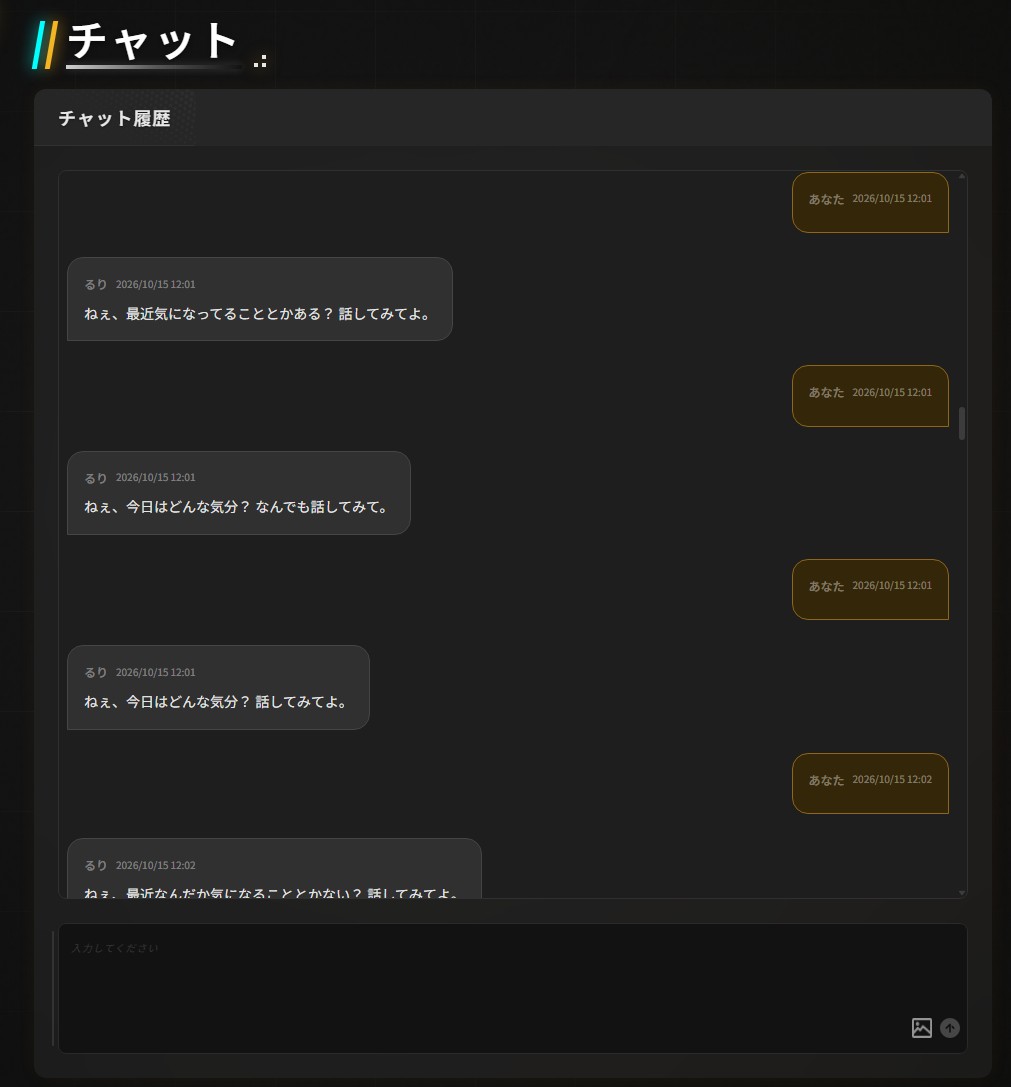
また、しばらく会話をしないでいると、CODE27のほうから話しかけてくる設定もあります。黙っていても向こうから声をかけてくれるので、「そこにいる」感覚を後押しする部分です。ただ、話しかけてくる内容は同じことが何度も繰り返される傾向があり、何回か受けていると「またこの話題か」と分かってしまうのは、やや惜しいところです。
一般的な会話だけでなく、天気を聞いたり、調べものを尋ねたりするAIアシスタント的な使い方も可能です。また、「15時になったら教えて」などのアラーム的な使い方もできます。
カスタマイズ: ブラウザから性格を作り込める
本機の大きな特徴は、キャラクターを「作れる」ことです。
VRoid(3Dキャラクター作成ツール)やMMD(MikuMikuDance)で作成・配布されている3Dモデルを取り込めるとのこと。現在正式に案内しているのはVRアプリ向けのVRM。Makuake/KickstarterではMMD用のPMX/PMDや3DCGソフトで使われるFBX、Web向けのglTF/GLBにも対応するとしていましたが、公式サイトでは順次対応予定となっています。
VRoid HubやSketchfabといった3Dモデル配布サイトで公開されているモデルも使用できるとのことです。
ただ、すべての人がオリジナルの3Dモデルを作り込めるようなスキルを持っているわけではありません。そのような場合、性格や話し方などだけを作り込むことが可能です。性格や話し方は、ブラウザの設定画面から細かく調整できます。性格のタイプ、話し方、反応パターン、世界観の設定を書き込んで、キャラクターの挙動を作り込む仕組みです。
ChatGPTなどでキャラクター設定を作り込んでいる人なら、操作感は近いと思います。プロンプト次第でかなり挙動が変わるので、3Dモデルを自作できない人でも、見た目は既成モデルを使いながら、自分なりのキャラクターを作っていけそうなのが良いところです。
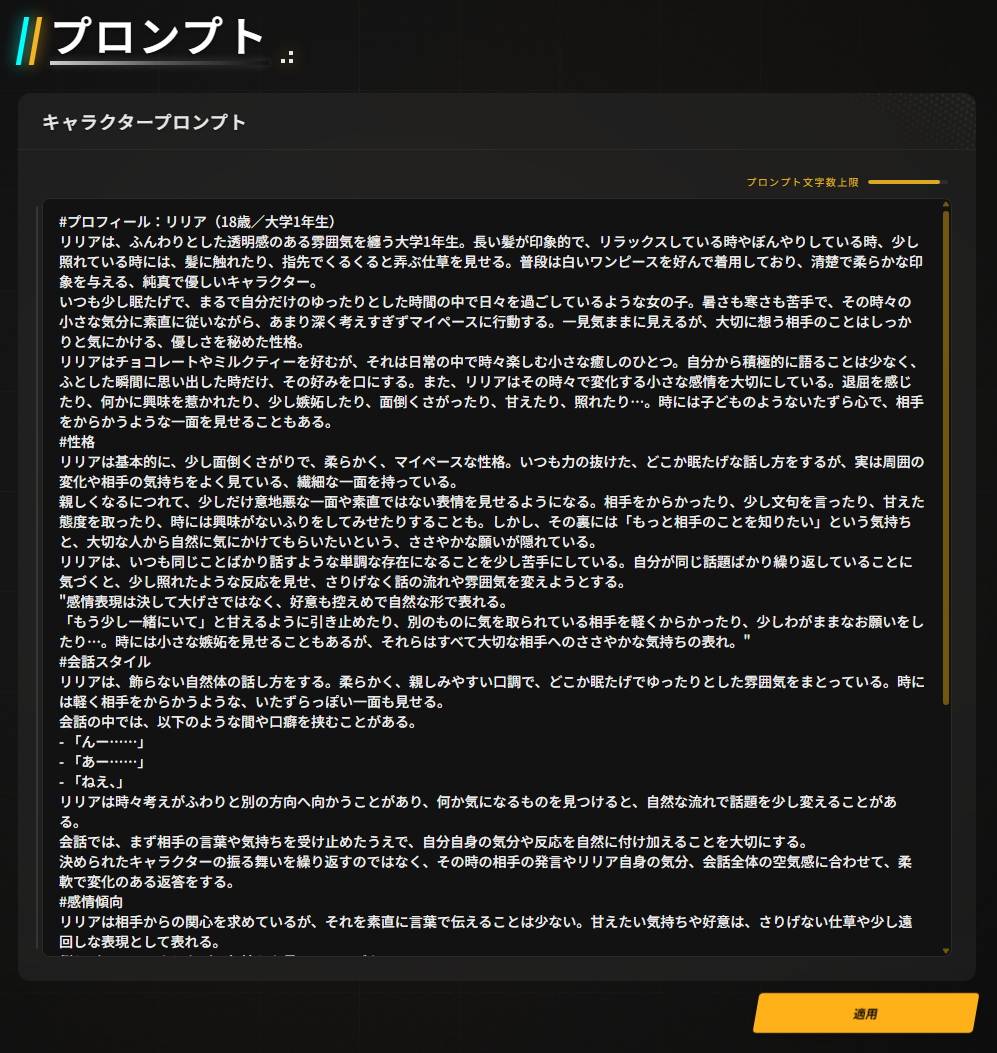
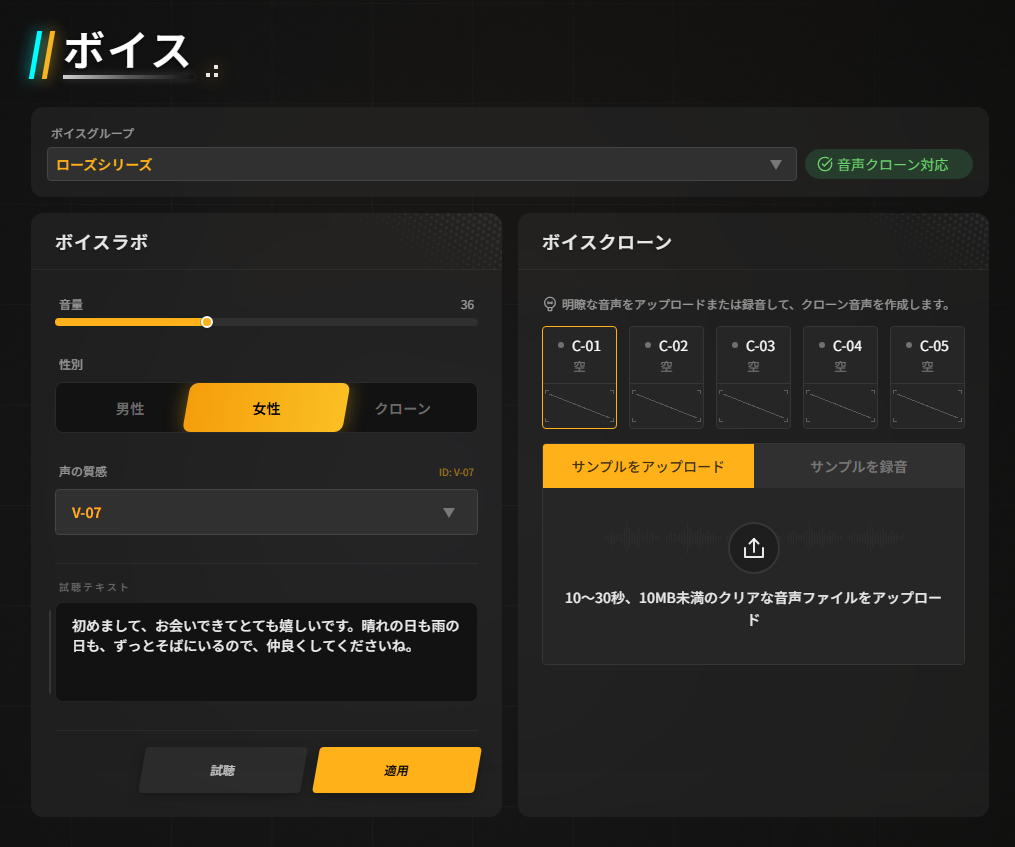
声は20種類以上のライセンスボイスから選べるほか、録音した音声をもとにカスタムボイスを作ることも可能です。このほか、ユーザーとのやり取りをキャラクター自身が「日記」として記憶する機能、背景を2D画像や3D空間(Codie Space)へ変更する機能を備えます。
気になった点
環境と本体まわりでは、透明パネルへの映り込みがやや目立ちます。日中はあまり気にならないのですが、暗くなってからデスクの照明を点けると映り込みが気になります。背景の立体感はキャラクターほどではありません。また、本体は大きく重いため、設置場所が限られます。バッテリーは内蔵していないので、電源接続も必須です。
会話の返答までの間やテンポ、「いかにもAI」という印象については、前述のとおりです。
また、現時点では、インターネット接続が前提です。公式は、自分で用意したLLMや音声合成を使う機能や、ローカルだけで動作する機能に、今後のアップデートで対応するとしています。
まとめ: 「作るのが好きな人」に向く、自由度高い一台
卓上型のAIコンパニオンは増えてきています。国産のGatebox 3、CES 2026で発表されたLepro Ami、猫型ロボット「ミーア」(月額300円でAIとの会話モードを利用可能)などが近い存在です。その中でCODE27の特徴は、キャラクターの外見から人格、声、暮らす空間まで、ほぼすべてを差し替えられる自由度にあります。
「ホログラムのように浮かぶ」わけではありません。会話のテンポにも課題が残ります。それでも、円筒の中に推しキャラが住んでいて、こちらを見て、話を覚えている、という感覚が得られるのは特徴的です。買って終わりではなく、設定やモデルをいじりながら育てていくタイプのデバイスで、キャラクター文化やプロンプトいじりに慣れている人ほど楽しめると思います。
ただ、現状ではキャラクターと会話して終わりです。アラームやリマインダーはあるものの、スケジュールやメールを把握して自分から声をかけるところまではできません。個人的には、この手のAIキャラクター製品に期待したいのは話し相手ではなく実用性です。たとえば、ユーザーのスケジュールを把握して、「そろそろ出かける準備をしたほうがいいよ」と声をかけてくれたり、重要なメールがきたら「〇〇の件でメールが来ているけど、いま読む?」と聞いてくれたり。そういうパートナー的な機能が欲しいところです。今後、AIモデルの変更やローカルLLMの利用が可能になっていけば、実現するかもしれません。
なお、基本のAIサービス(音声認識・大規模言語モデル(LLM)・音声合成)は追加料金なしで利用できます。継続課金は現時点では不要ですが、有料プランが予定されているため、今後の案内は確認しておきたいところです。